01 · KLINISCHE FRAGE
Wofür soll das System eingesetzt werden?
Patientengruppe, Versorgungspfad, Entscheidung und relevanten Endpunkt festlegen.
KI verstehen. Medizinisch bewerten. Verantwortlich anwenden.
Beurteilen Sie KI-Systeme, medizinische Studien und Anbieterangebote fundiert – und planen Sie den verantwortlichen Einsatz in Klinik und Praxis. Dafür arbeiten Sie selbst mit medizinischen Daten, Modellen und KI-Agenten: angeleitet und ohne vorausgesetzte Programmiererfahrung.
Das Programm richtet sich an medizinische Entscheiderinnen und Entscheider, die Qualität, Risiken und klinische Relevanz von KI-Systemen fundiert einordnen müssen.
Künstliche Intelligenz verändert Diagnostik, Forschung und medizinische Entscheidungsprozesse. Für Ärztinnen und Ärzte reicht es deshalb nicht aus, KI-Systeme nur bedienen zu können.
Entscheidend ist, zu verstehen, wie Ergebnisse entstehen, ob sie für eine konkrete Patientengruppe belastbar sind und wo Halluzinationen, Verzerrungen, fehlende Validierung oder Automation Bias die ärztliche Entscheidung gefährden können.
Es geht nicht darum, Ärztinnen und Ärzte zu Softwareentwicklern zu machen. Es geht um medizinische Urteilskraft im Umgang mit KI.
Anbieter und Betreiber von KI-Systemen müssen Maßnahmen ergreifen, um die Entwicklung der KI-Kompetenz ihres Personals und anderer beauftragter Personen zu unterstützen. Sie müssen dabei kein bestimmtes Niveau an KI-Kompetenz für einzelne Personen garantieren. Diese Fortbildung vermittelt Ärztinnen und Ärzten fachliche Grundlagen, um KI-Systeme im medizinischen Kontext kompetent und verantwortlich zu beurteilen.
Aktuellen Artikel 4 ansehen →Patientengruppe, Versorgungspfad, Entscheidung und relevanten Endpunkt festlegen.
Leistung, Kalibrierung, Verzerrungen und Aussagekraft im klinischen Kontext prüfen.
Validierung, Datenschutz, ärztliche Kontrolle und regulatorische Vorgaben zusammenführen.
Sechs Fähigkeiten, die über einzelne Tools hinaus Bestand haben – für fundierte Entscheidungen über KI in Klinik und Praxis.
Patientengruppe, Einsatzzweck, Versorgungspfad und klinisch relevanten Endpunkt für einen eigenen Anwendungsfall festlegen.
Einen vorbereiteten medizinischen Datensatz untersuchen, erste Modellschritte selbst durchführen und die Ergebnisse kritisch auswerten.
Prompts und RAG-Abläufe erproben, Halluzinationen erkennen und generierte Ausgaben medizinisch bewerten.
Unter Anleitung eine klar begrenzte, bildbasierte Entscheidungsunterstützung im Lernkontext aufbauen und testen.
Leistung, Kalibrierung, Verzerrungen, Generalisierbarkeit und klinischen Nutzen unterscheiden.
Anbieterangaben, Validierung, EU AI Act, MDR, Datenschutz und ärztliche Kontrolle in einen realistischen Transferplan übersetzen.
Die technische Tiefe bleibt immer an konkrete ärztliche Fragen gekoppelt. Sie lernen nicht Modelle um ihrer selbst willen, sondern um Qualität, Risiken und Einsatzgrenzen im klinischen Alltag zu erkennen.
Jedes Level führt von der medizinischen Fragestellung über Daten und Modell zur kritischen Bewertung und zum Transfer in den eigenen Arbeitskontext.
Selbst mit Daten und Modellen arbeiten, Ergebnisse medizinisch bewerten
Einen eigenen Anwendungsfall strukturieren, vorbereitete medizinische Daten untersuchen und Qualitätsprobleme oder Verzerrungen erkennen.
In einer vorbereiteten Umgebung eine lineare Regression und einen Entscheidungsbaum trainieren und vergleichen. Modellgüte, Kalibrierung, Überanpassung und klinische Aussagekraft kritisch einordnen.
Prompts und RAG-Abläufe erproben, Halluzinationen erkennen und Ausgaben assistiver, agentischer und multimodaler Systeme medizinisch prüfen.
Studien und Modellergebnisse auf AUC-Fallen, Dataset Leakage, Subgruppenleistung, externe Validierung und Generalisierbarkeit prüfen.
Versprechen wie „96 % Genauigkeit“ auf Population, Prävalenz, Referenzstandard, externe Validierung, relevante Fehler, Drift und Verantwortlichkeiten prüfen.
Zwei selbst trainierte Lernmodelle, eine medizinische Studien- und Anbietercheckliste sowie die strukturierte Skizze eines eigenen Anwendungsfalls für Praxis, Klinik oder Abteilung. Als Arbeitsmaterial erhalten Sie außerdem wiederverwendbare Notebook-/Python-Vorlagen, eine Prompt-Bibliothek für Ärztinnen und Ärzte und eine kuratierte KI-Tool-Liste für Praxis und Klinik. Im Zertifizierungsweg bilden die Ergebnisse den Ausgangspunkt für das Capstone-Projekt.
Einen bildbasierten Lernprototyp entwickeln, Grenzen prüfen, Einführung planen
Der kompakte Primer wiederholt zentrale Begriffe zu Daten, Modellgüte und Validierung. Level 2 bleibt eigenständig buchbar; der Primer ist ein freiwilliges Zusatzangebot und keine Teilnahmevoraussetzung.
Mit vorbereiteten medizinischen Bilddaten ein kompaktes Convolutional Neural Network trainieren, Transfer Learning anwenden und Grad-CAM-Heatmaps medizinisch interpretieren.
Eine klar begrenzte bildbasierte Entscheidungsunterstützung entwickeln und an Fehlklassifikationen, Domain Shift, Geräteabhängigkeit und Subgruppenproblemen prüfen.
Validierung, laufende Überwachung, EU AI Act, High-Risk AI, MDR/Medical Device Software, Datenschutz, Human Oversight, Dokumentation und Verantwortlichkeiten zusammenführen.
Für einen eigenen medizinischen Anwendungsfall Workflow, mögliche PACS-Anbindung, Teamakzeptanz, Prüfanforderungen und nächste Schritte planen. Teilnehmende am Zertifizierungsweg bereiten hier Capstone und Viva vor.
Ein klar begrenzter bildbasierter KI-Lernprototyp mit Grad-CAM-Auswertung und ein strukturierter Plan für Evaluation, Validierung und verantwortungsvolle Weiterentwicklung. Dazu kommen wiederverwendbare Notebook-/Python-Vorlagen, eine Studiencheckliste für Bild-KI, eine Prompt-Bibliothek und eine kuratierte KI-Tool-Liste. Der Prototyp dient ausschließlich der Fortbildung.
Die Übungen vertiefen unter anderem Sensitivität, Spezifität, PPV/NPV, ROC-AUC, Kalibrierung, Klassenungleichgewicht, Spektrumbias und Subgruppenleistung sowie interne, externe und prospektive Validierung. Ebenfalls behandelt werden Automation Bias, Generalisierbarkeit, Dataset Shift und Model Drift. Die Begriffe werden immer an ihrer klinischen Bedeutung und nicht als isolierter Statistikblock vermittelt.
Das Bundle verbindet beide Präsenzlevel mit zwei moderierten Online-Sessions für aktuelle Entwicklungen, eigene Fallfragen und die Vorbereitung des Capstones.
Mit Daten, Modellen, KI-Agenten und Sprachmodellen praktisch arbeiten.
Einen Lernprototyp entwickeln, Grenzen prüfen und Einführung planen.
Beide Level abschließen, den eigenen Anwendungsfall ausarbeiten und fachlich begründen.
Verständliche fachliche Inputs werden unmittelbar in konkrete Übungen übersetzt. Sie arbeiten in einer vorbereiteten Umgebung, verändern Parameter, vergleichen Ergebnisse und besprechen gemeinsam, was medizinisch belastbar ist.
Sie nehmen eigene Arbeitsergebnisse mit und können die zugrunde liegenden medizinischen und methodischen Entscheidungen fachlich begründen.
Ihre Dozenten verbinden KI-Strategie und Modellverständnis mit klinischer Anwendung, medizinischer Führung und verantwortlicher Implementierung.
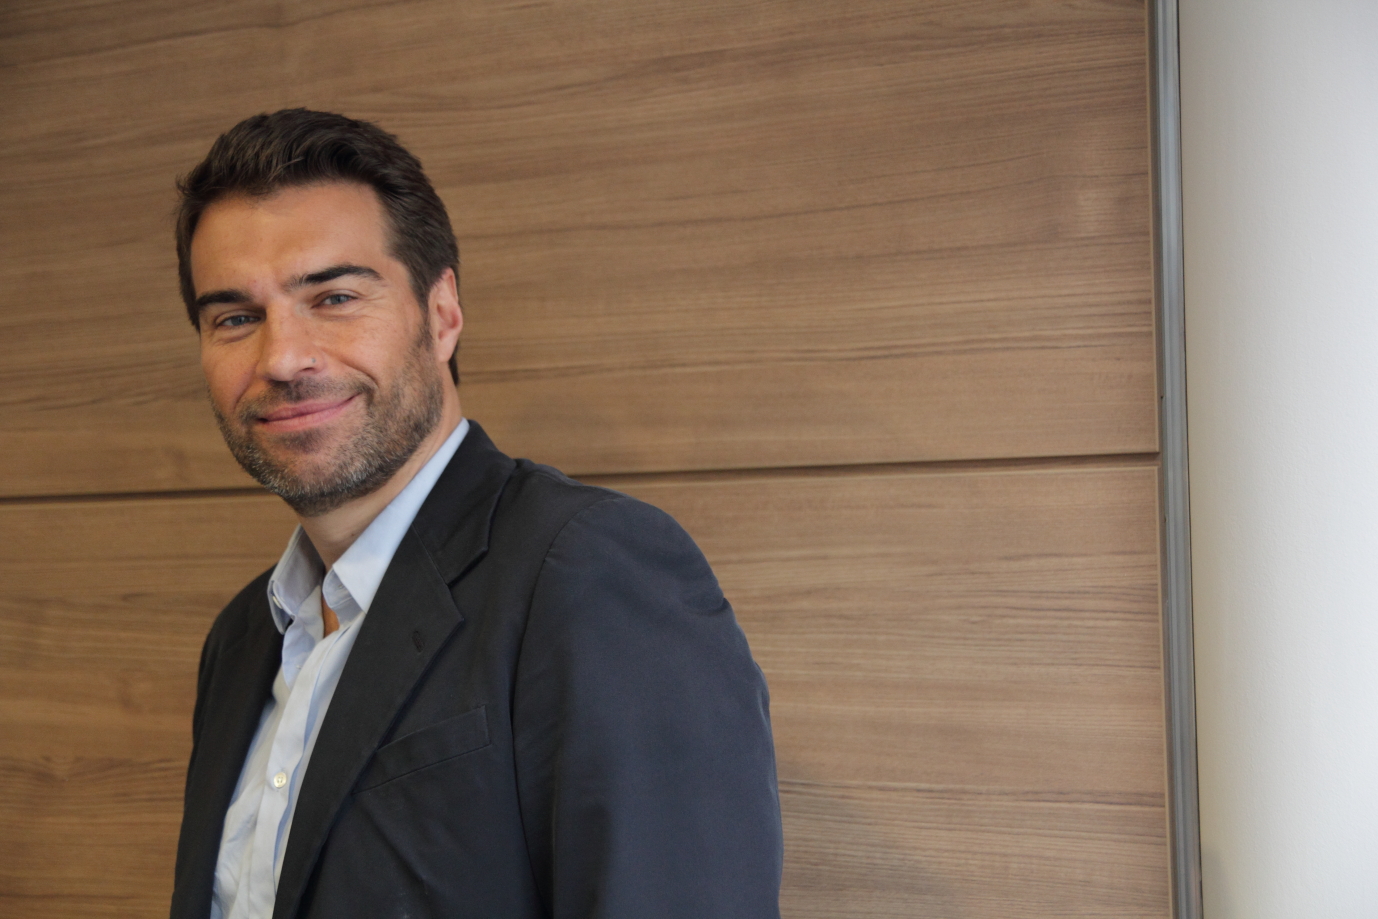
Er ist renommierter KI-Experte und Professor für Künstliche Intelligenz an der Hochschule Fresenius. Als Studiendekan leitet er den Studiengang „Digitales Management & Leadership“ und unterrichtet seit Jahren Maschinelles Lernen und angewandte Künstliche Intelligenz. Er verfügt – neben seiner hohen fachlichen und didaktischen Erfahrung – durch seine medizinische Ausbildung (Master-Studium in Molekularmedizin, Immunologie und Pathologie in den USA) und seine langjährige Arbeit im Umfeld „Digitale Medizin“ auch über das Verständnis der Sprache und der Anforderungen aus der medizinischen Praxis.
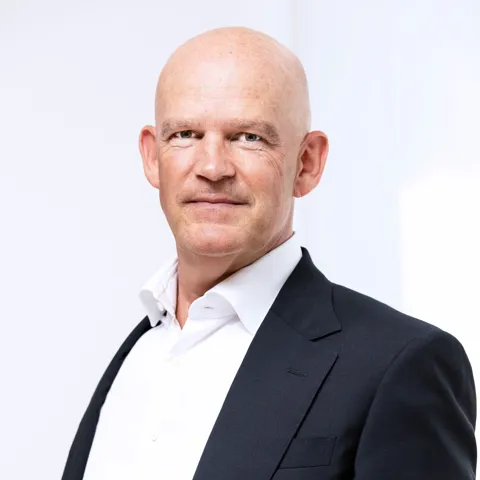
Prof. Dr. med. Alexander Muacevic ist Direktor des Europäischen Radiochirurgie Centrums München und klinisch tätiger Radiochirurg. Er bringt die Perspektive aus Hochpräzisionsmedizin, medizinischer Bildgebung und ärztlichen Entscheidungsprozessen ein.
Sie können Level 1 oder Level 2 unabhängig voneinander besuchen. Das Abschlusszertifikat „ERCM Certified Medical AI Professional“ erhalten Sie nach beiden Leveln und erfolgreicher Kompetenzüberprüfung mit eigenem Transferprojekt (Capstone) und Fachgespräch (Viva).
Die freiwilligen Grand Rounds unterstützen den Lerntransfer, sind aber kein Bestandteil der Kompetenzprüfung.
Capstone-Bewertung und Viva sind ohne Zusatzgebühr enthalten, wenn Sie beide Level buchen – als Bundle oder in zwei getrennten Buchungen. Die Workshops können Sie auch ohne Teilnahme am Zertifizierungsweg besuchen.
Kompetenzprofil
Beide Workshops sind unabhängig voneinander buchbar. Das empfohlene Bundle verbindet beide Präsenzlevel, die zwei freiwilligen Grand Rounds und den vollständigen Zertifizierungsweg.
5.–6. März 2027 · München-Großhadern
29.–30. Oktober 2027 · München-Großhadern
5.–6. März & 29.–30. Oktober 2027
Sie können jedes Level einzeln buchen oder mit dem empfohlenen Bundle beide Präsenzlevel, die freiwilligen Grand Rounds und den vollständigen Zertifizierungsweg verbinden.